
Kapitel 5
Struktur, Schema.org und maschinenlesbare Daten

Inhaltsverzeichnis
Kapitel 2 hat gezeigt, was Shopware im Standardtemplate automatisch mitbringt. Dieses Kapitel beantwortet die Anschlussfrage: Was müssen Sie selbst ergänzen, und in welcher Reihenfolge? Die Antwort vorweg: Maschinenlesbarkeit entsteht nicht dadurch, dass man möglichst viele technische Formate ergänzt. Sie entsteht dadurch, dass dieselbe korrekte Information überall konsistent ausgespielt wird.
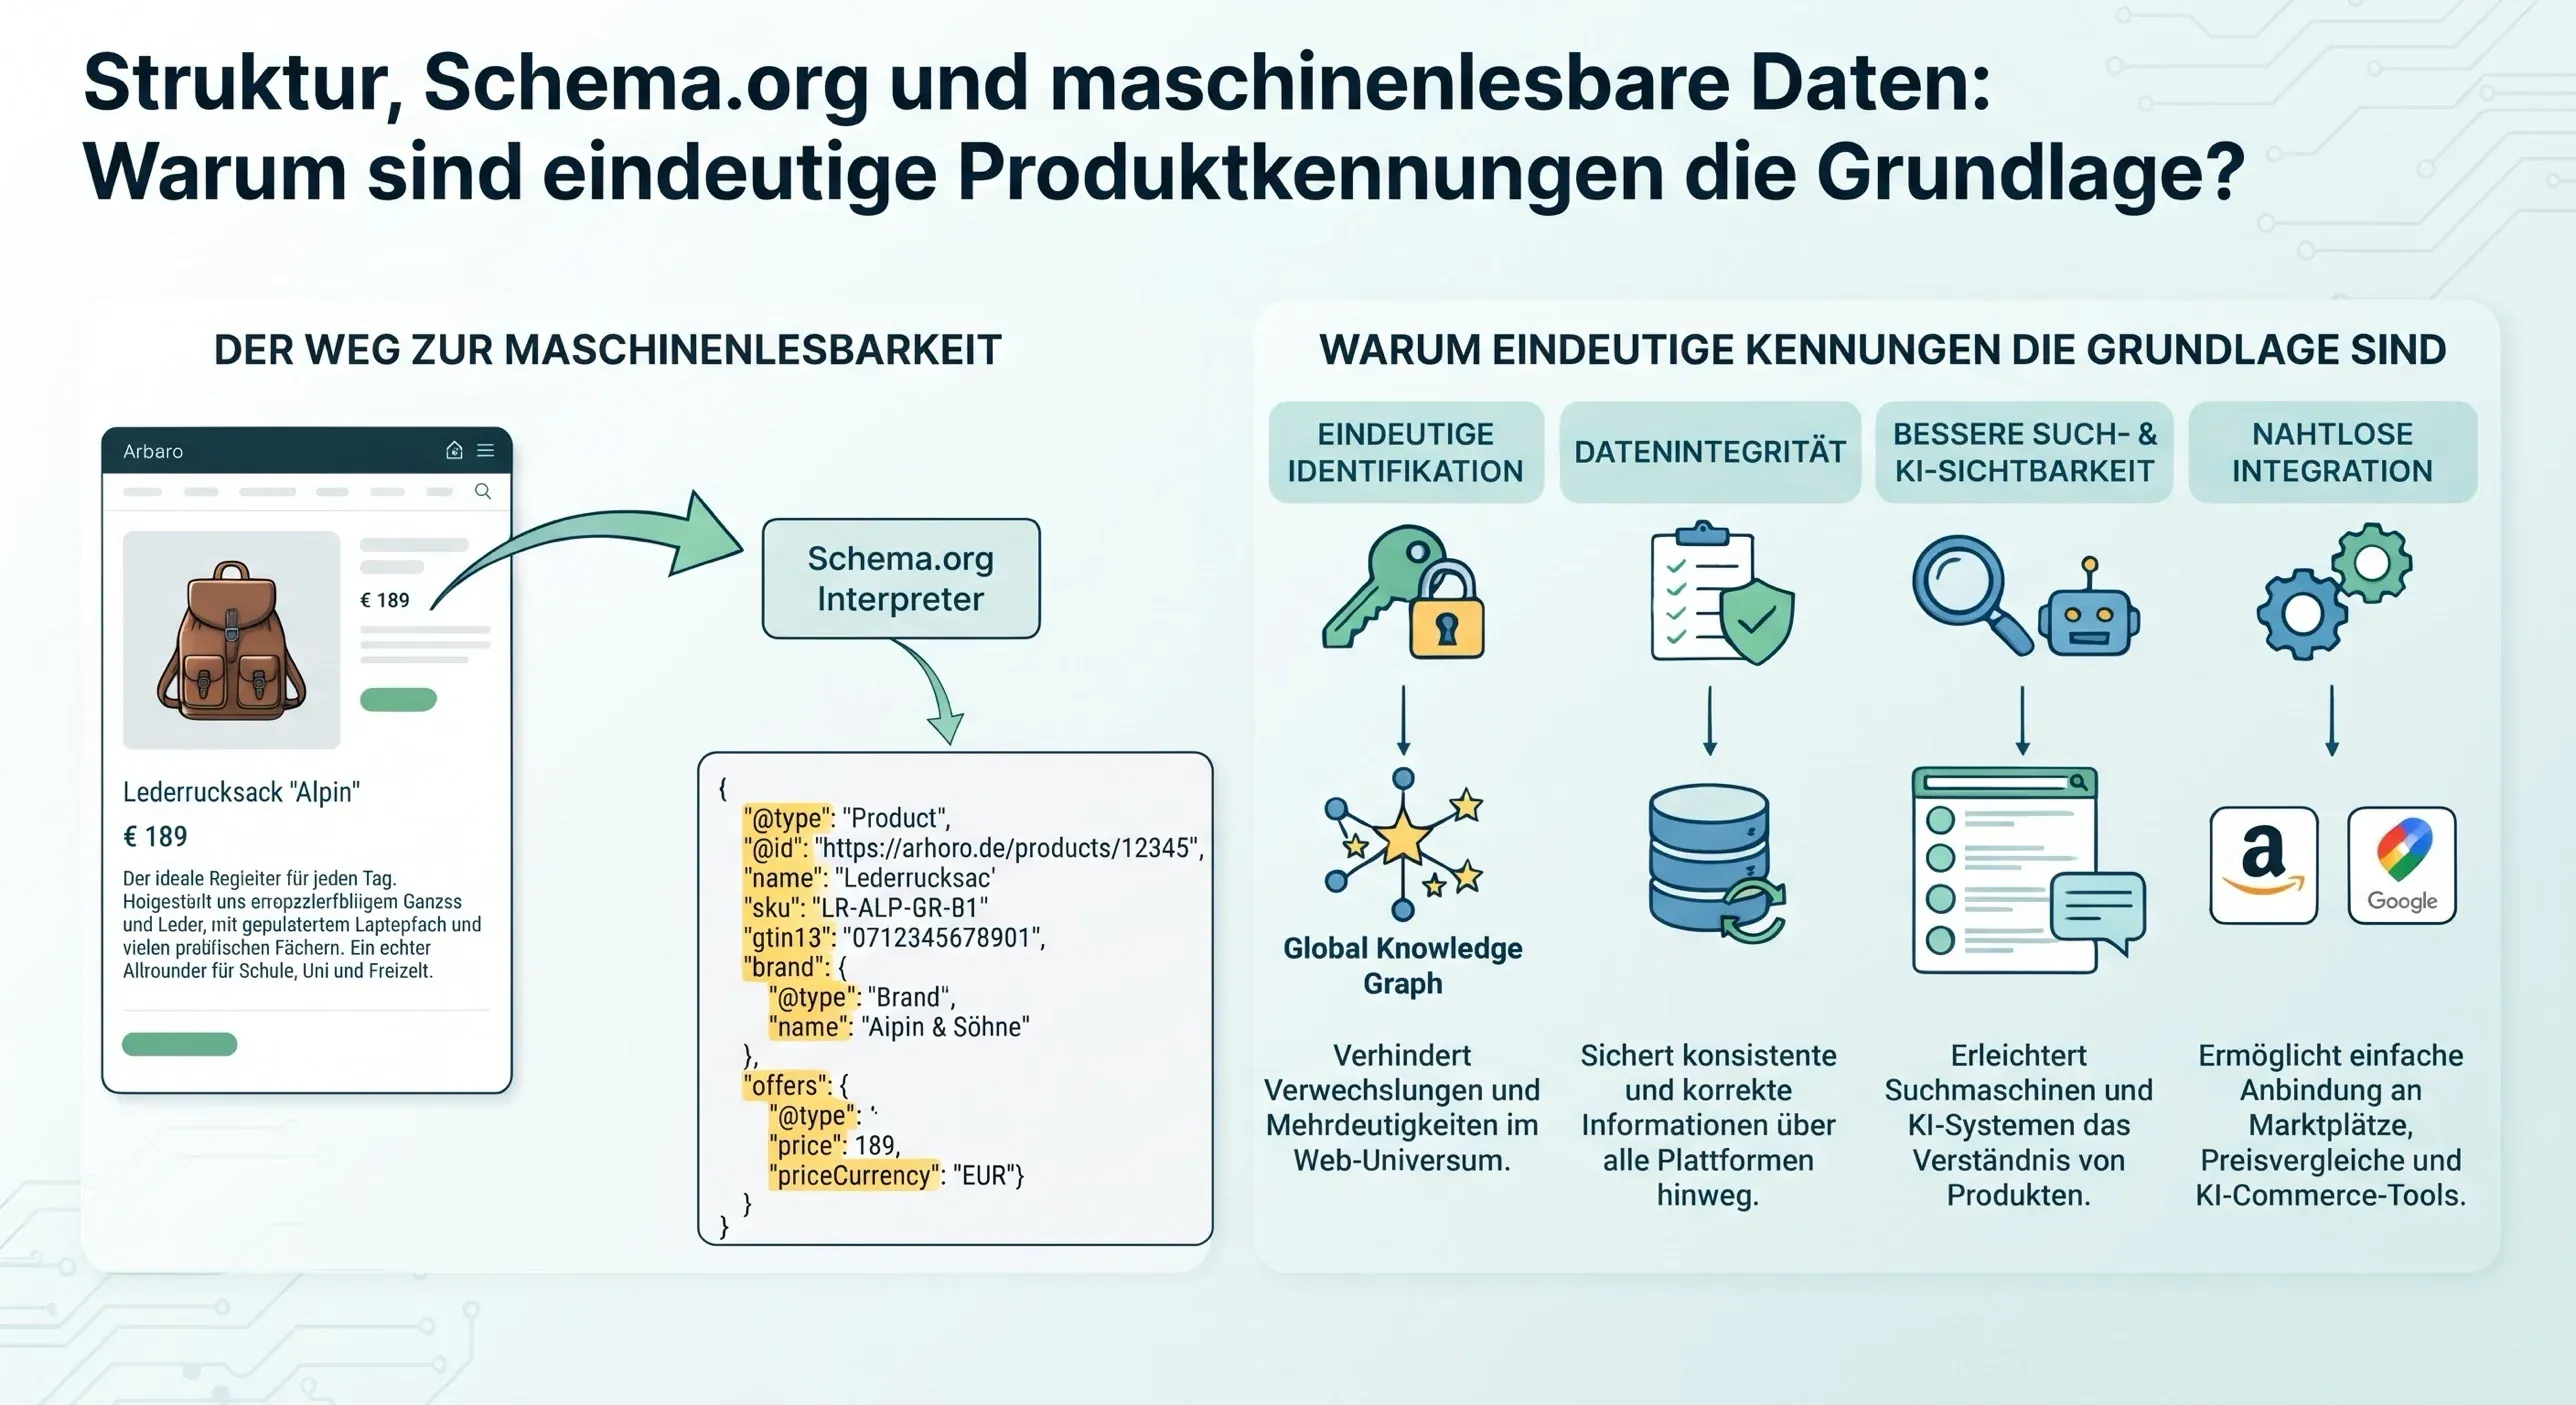
Warum sind eindeutige Produktkennungen die Grundlage?
Bevor irgendein Schema-Typ etwas nützt, muss die Produktidentität stimmen – und Identität ist mehr als eine GTIN. Bei Markenware sind die vom Hersteller vergebenen Kennungen die wertvollsten: GTIN und MPN, die Herstellernummer. Beide sind nachzupflegen, nicht neu zu erzeugen. Die interne Artikelnummer, die SKU, ist davon zu unterscheiden – sie identifiziert das Produkt in Ihrem System, nicht am Markt.
GTIN: eindeutige Produktidentität am Markt. Vom Hersteller vergeben, bei Eigenmarken über GS1.
MPN: Herstellernummer des Produkts. Vom Hersteller vergeben.
SKU: interne Artikelnummer aus Ihrem eigenen System – kein Marktidentifikator.
Bei echten Eigenmarken, bei denen der Shop selbst als Hersteller auftritt, gelten andere Regeln: Eine korrekte GTIN-Vergabe läuft über eine GS1-Mitgliedschaft und eine zugewiesene Basisnummer. Eine GTIN zu erfinden oder von einer Handelsplattform zu kaufen, kann gegen die Richtlinien von Google Merchant Center und vergleichbaren Feeds verstoßen und im schlechtesten Fall zur Sperrung des Feeds führen. Für Produkte, denen keine solchen eindeutigen Produktkennungen zugewiesen wurden – etwa bestimmte Unikate oder Sonderanfertigungen –, sieht Google Merchant Center identifier_exists = false vor, statt eine Kennung vorzutäuschen.
Wo fehlt Schema tatsächlich noch?
Shopwares automatisches JSON-LD deckt Produkt-, Kategorie- und Suchseiten ab. Was es nicht abdeckt: Ratgeberartikel, Anleitungen, redaktionelle Inhalte. Hier ergänzen Sie selbst – aber nach einem einfachen Prinzip: Schema wird nach vorhandenem Inhalt ausgewählt, nicht Inhalt produziert, damit man ein Schema einsetzen kann.
Für Ratgeberartikel bietet sich Article- oder BlogPosting-Schema an, für Schritt-für-Schritt-Anleitungen HowTo-Schema. Für Frage-Antwort-Bereiche kann FAQPage-Schema weiterhin sinnvoll sein, wenn die ausgezeichneten Fragen und Antworten tatsächlich sichtbar auf der Seite stehen. Einen eigenständigen GEO-Effekt sollte man davon allerdings nicht erwarten. Google hat HowTo-Rich-Results bereits 2023 eingestellt; FAQ-Rich-Results erscheinen seit Mai 2026 ebenfalls nicht mehr in der Google-Suche. Ob und wie einzelne KI-Systeme dieses Markup für ihre Quellenauswahl verwenden, ist nicht belastbar dokumentiert.
Wie setzen Sie Schema technisch sauber um?
Zwei Regeln, die in der Praxis am häufigsten verletzt werden. Erstens: Schema auf Template-Ebene implementieren, nicht pro Einzelseite. Ein Shop hat keine tausend individuellen Seiten, sondern eine Handvoll Templates, die tausend Seiten erzeugen.
Zweitens, und das ist der eigentliche Kern dieses Kapitels: Schema muss exakt dem sichtbaren Inhalt entsprechen. Wenn ein Produkt ausverkauft ist und die Seite das anzeigt, das Schema aber noch Verfügbarkeit meldet, entsteht eine Diskrepanz – mit Fehlern und im schlechtesten Fall dem Verlust der Rich-Result-Berechtigung.
Die sicherste Absicherung: Solche Abweichungen entstehen selten aus schlechter Absicht, sondern fast immer dadurch, dass sichtbare Daten aktualisiert werden und das Schema aus einer separaten Quelle stammt. Speisen Sie das Schema aus derselben Datenquelle, die auch die sichtbare Seite rendert.
Warum eine Datenbasis für mehrere Ausgabekanäle?
Produktdaten sollten intern einmal sauber und vollständig gepflegt werden – daraus können mehrere plattformspezifische Ausgaben entstehen. Google Merchant Center, Shopwares Agentic Product Feed und weitere KI-Plattformen haben unterschiedliche Formate und Anforderungen. Die falsche Konsequenz wäre, dafür mehrere voneinander unabhängige Produktdatenbestände zu pflegen. Die richtige Konsequenz ist eine belastbare Datenbasis im Shop, aus der die jeweiligen Feeds automatisiert erzeugt werden.
Was unterscheidet Feeds von Sitemaps?
Ein Punkt, der in der Praxis regelmäßig durcheinandergeht: Ein Produktfeed transportiert strukturierte Commerce-Daten an eine Plattform, die diese Daten erwartet und verarbeitet. Eine Sitemap hilft einem Crawler dabei, relevante URLs und Inhalte eines Shops systematisch zu entdecken. Beides kann sinnvoll sein, aber das eine ersetzt das andere nicht.
Welcher Zielkonflikt bei Varianten wird übersehen?
Bei Varianten entsteht ein Konflikt zwischen zwei berechtigten Anforderungen. Aus SEO-Sicht werden Varianten-URLs per Canonical auf die Hauptproduktseite gebündelt, damit Google nicht hunderte nahezu identische Seiten indexiert und Rankingsignale unnötig verteilt.
Für KI-Crawler entsteht daraus ein anderes Problem: Wer dem Canonical folgt, bekommt die einzelnen Variantenausprägungen praktisch nicht mehr zu sehen. Ob es die Laufjacke in Rot, Größe XXL und mit genau diesem Produktbild gibt, steckt zwar im Shop – ist für den Crawler aber nicht mehr zuverlässig als zusammengehörige Information verfügbar.
Die Lösung besteht nicht darin, die Canonical-Logik aufzugeben. Sie besteht darin, diese Detailinformationen zusätzlich auf einem eigenen, maschinenlesbaren Weg bereitzustellen.
Genau dafür haben wir bei arboro die AI-Sitemaps für Shopware entwickelt. Die Erweiterung stellt vier separate Sitemaps für Produkte, Bilder, FAQ-Inhalte und Kategoriethemen bereit. Variantenattribute wie Farbe, Größe und weitere Eigenschaften werden strukturiert direkt beim Produkt ausgegeben – unabhängig davon, wie die Varianten-URLs über Canonicals behandelt werden.
Zusätzlich normalisiert die Erweiterung Produktinformationen, die in vielen Shops nur als Freitext oder uneinheitlich gepflegte Felder vorliegen, etwa Maße, Material oder Volumen. Statt dass ein KI-Crawler zehntausende Produkt- und Varianten-URLs einzeln interpretieren muss, bekommt er die relevanten Informationen kompakt und maschinenlesbar bereitgestellt.
Die AI-Sitemaps laufen dabei bewusst getrennt vom klassischen SEO-Pfad: Sie lassen sich für KI-Crawler freigeben und gegenüber klassischen Suchmaschinen von der Indexierung ausschließen. Die arboro AI-Sitemaps sind kostenlos im Shopware Store verfügbar.
Wie viel bringt eine llms.txt?
Seit rund zwei Jahren kursiert die Empfehlung, zusätzlich zur robots.txt eine llms.txt-Datei anzulegen – ein Inhaltsverzeichnis in Textform speziell für KI-Systeme. Die bisherige Datenlage rechtfertigt keine hohe Priorität. Google hat öffentlich bestätigt, keine Unterstützung zu planen, und den Vergleich zum längst wirkungslosen Keywords-Meta-Tag gezogen. Eine Analyse von über 500 Millionen KI-Bot-Zugriffen fand, dass die großen KI-Suchcrawler die Datei in der Praxis nahezu nie abrufen.
Unsere Einordnung dazu ist deshalb einfach: Kann man machen. Muss man derzeit nicht. Wer fehlende GTINs hat, schlechte Produktdaten ausliefert, KI-Crawler blockiert oder wichtige Inhalte erst per JavaScript erzeugt, hat wichtigere Baustellen. Eine llms.txt vor diesen Grundlagen zu priorisieren, optimiert die falsche Stelle.
Für Shopware-Shops ist der Aufwand inzwischen ohnehin gering: Seit Version 6.7.12.0 lassen sich llms.txt und agents.md direkt in den Einstellungen des Verkaufskanals aktivieren, ohne Plugin und ohne eigene Programmierung. Wer auf aktuellem Stand ist, kann die Dateien deshalb mitnehmen. Eine messbare Wirkung sollte er davon derzeit nicht erwarten – und sie ersetzt keine der Grundlagen oben.
Unsere Einordnung: die richtige Reihenfolge
Für Produktdaten gilt diese Reihenfolge:
Saubere Produktidentität
Zentrale Datenbasis im Shop
Schema und Feeds
Discovery-Strukturen wie Sitemaps
Experimentelle Formate
Für Produktdaten beginnt die Reihenfolge mit sauberer Produktidentität. Danach folgt eine zentrale Datenbasis im Shop. Aus ihr entstehen strukturierte Seitendaten und die Feeds für Plattformen, die Ihre Produkte verarbeiten sollen. Discovery-Strukturen wie Sitemaps helfen anschließend bei der Auffindbarkeit. Experimentelle Formate kommen zuletzt.
Wer diese Reihenfolge umdreht und mit dem experimentellen Format anfängt, hat am Ende ein technisch modernes Setup auf einer unsauberen Datenbasis. Das ist der teuerste Weg, um am Ende doch nicht empfohlen zu werden.
Häufige Fragen
Derzeit nicht vorrangig. Google plant keine Unterstützung, und eine Analyse von über 500 Millionen KI-Bot-Zugriffen fand, dass die großen KI-Suchcrawler die Datei nahezu nie abrufen. Fehlende GTINs oder blockierte Crawler sind wichtigere Baustellen.
Nein. Eine korrekte GTIN-Vergabe läuft über eine GS1-Mitgliedschaft. Erfundene oder gekaufte GTINs können gegen die Richtlinien von Google Merchant Center verstoßen. Für Produkte ohne Kennung ist identifier_exists = false vorgesehen.
Es kann sinnvoll sein, wenn die Fragen und Antworten sichtbar auf der Seite stehen. Einen eigenständigen GEO-Effekt sollte man nicht erwarten: Google zeigt seit Mai 2026 keine FAQ-Rich-Results mehr, und wie KI-Systeme das Markup nutzen, ist nicht belastbar dokumentiert.