
Kapitel 2
Der Shopware-Shop aus Sicht einer KI

Inhaltsverzeichnis
Öffnen Sie Ihre eigene Produktseite im Browser. Sie sehen Bilder, Preis, Beschreibung, Bewertungen, den Warenkorb-Button. Alles da. Jetzt stellen Sie sich dieselbe Seite als reinen Text vor – ohne Layout, ohne Farbe, ohne die Anordnung, die Sie mit Bedacht gewählt haben. Was davon kommt bei einer Maschine überhaupt an? Bei vielen KI-Systemen lautet die Antwort: weniger, als die meisten Shopbetreiber annehmen.
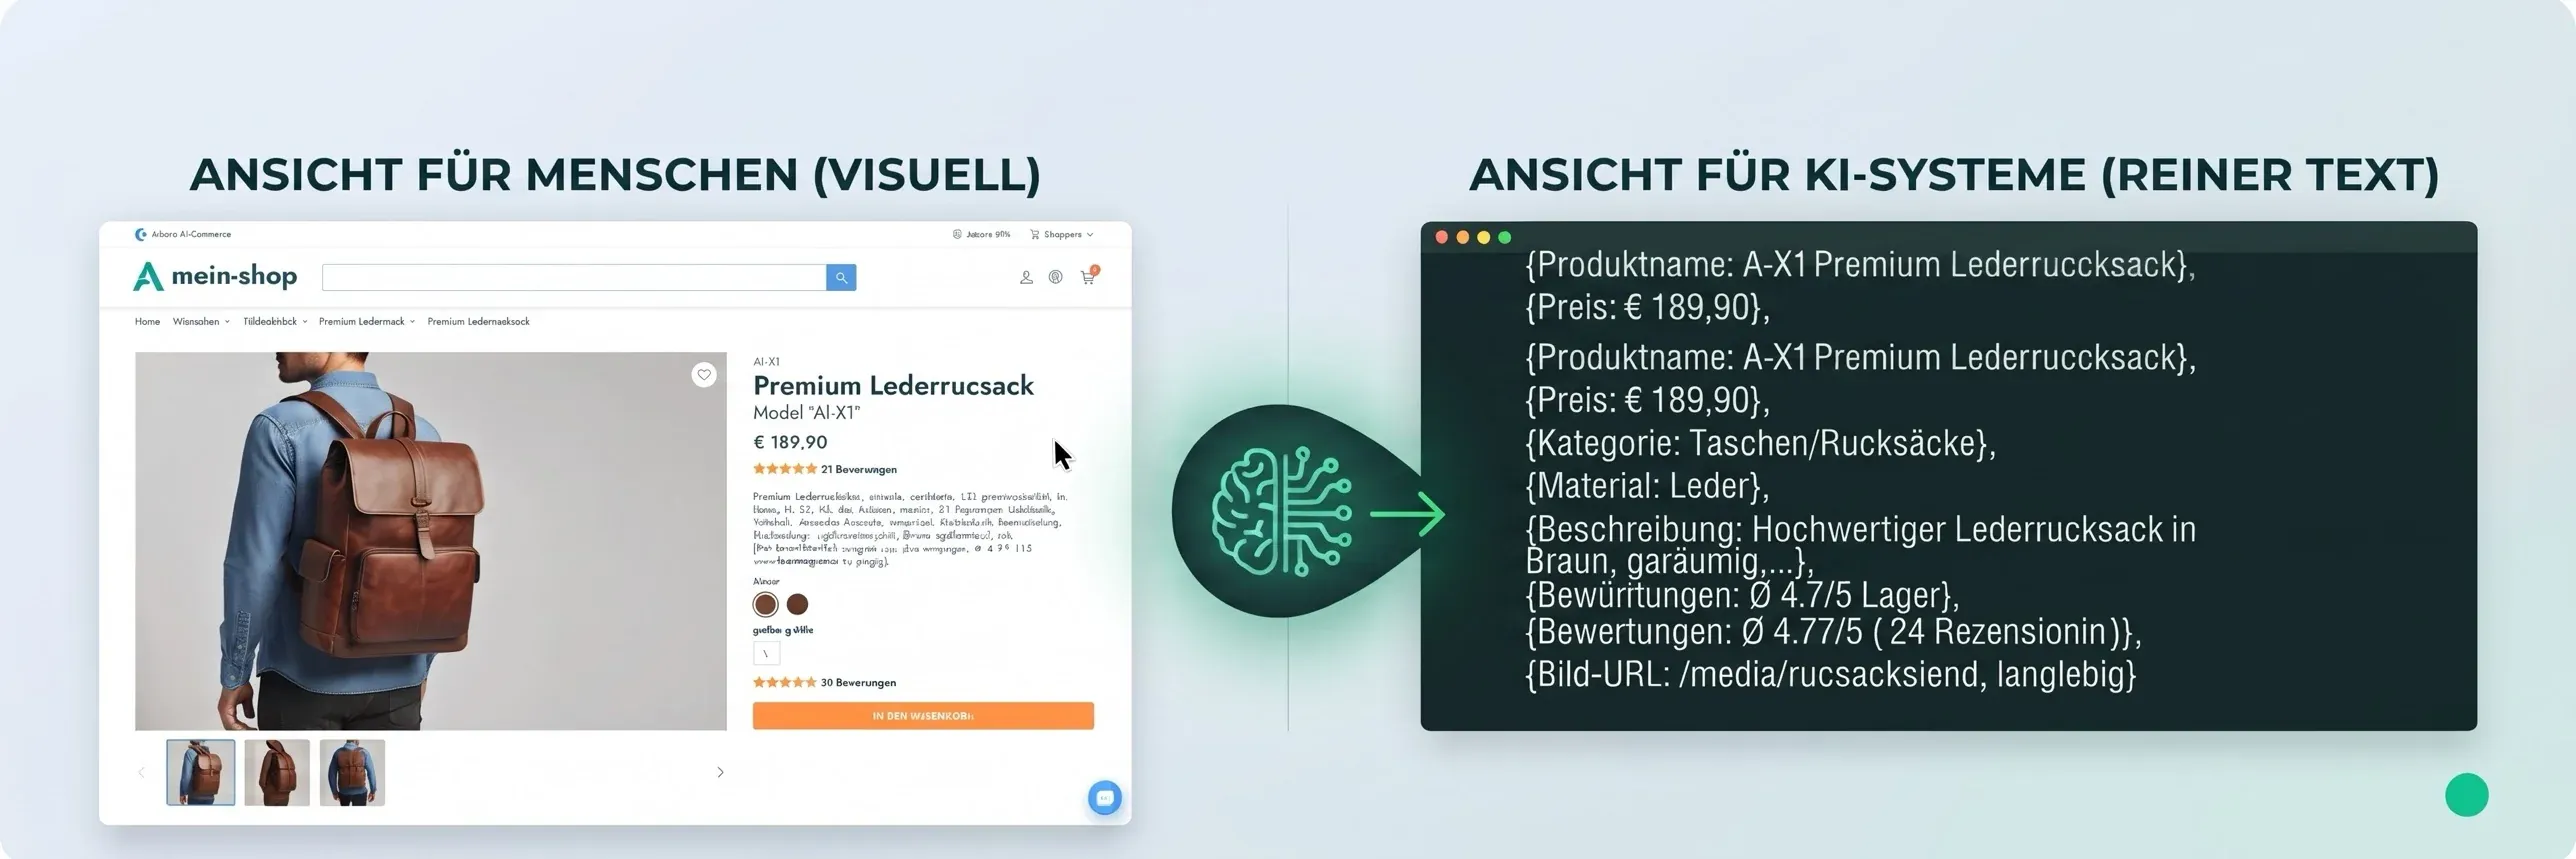
Warum kommen viele Inhalte bei KI-Crawlern gar nicht erst an?
Viele moderne Shop-Frontends – auch Shopware-Storefronts mit individuellem oder Headless-Aufbau – laden Inhalte per JavaScript nach, statt sie direkt im HTML auszuliefern. Für einen menschlichen Besucher macht das keinen Unterschied. Für die meisten KI-Crawler ist genau das die Wand.
Analysen von Vercel und MERJ zeigen: Die großen eigenständigen KI-Crawler, etwa von OpenAI, Anthropic und Perplexity, führen JavaScript nicht aus. Google ist hier anders aufgestellt – Gemini nutzt die Infrastruktur von Googlebot und kann rendern. Wo Preis, Verfügbarkeit oder Beschreibung erst per Skript entstehen, sieht ein OpenAI- oder Perplexity-Crawler also eine weitgehend leere Seite, unabhängig davon, wie sauber die robots.txt konfiguriert ist.
Was sieht der Kunde, was sieht der Crawler?
Dieselbe Produktseite, zwei Wahrnehmungen:
Produkt: Der Kunde sieht „Laufjacke“ – der Crawler auch.
Beschreibung: Der Kunde sieht sie vollständig – der Crawler sieht, dass sie vorhanden ist.
Preis: Der Kunde sieht 129 Euro – beim Crawler fehlt er.
Verfügbarkeit: Der Kunde sieht „sofort lieferbar“ – beim Crawler fehlt sie.
Varianten: Der Kunde sieht vier Farben – beim Crawler fehlen sie.
Bewertung: Der Kunde sieht 4,8 Sterne – beim Crawler fehlt sie.
Für den Kunden ist die Seite vollständig. Für die Maschine fehlen genau die Informationen, die sie für eine Empfehlung braucht.
Warum ist nicht jeder Bot derselbe Bot?
Hier entstehen in der Praxis die meisten Missverständnisse. Ein KI-Anbieter betreibt in der Regel mehrere Crawler mit unterschiedlicher Aufgabe. Bei OpenAI sammelt GPTBot Daten fürs Training der Modelle. OAI-SearchBot dagegen dient dazu, öffentliche Webinhalte für die ChatGPT-Suche zugänglich zu machen.
Der praktische Unterschied: Wer GPTBot aus Datenschutzgründen blockiert, kann OAI-SearchBot trotzdem gezielt zulassen. Trainingsdaten schützen und in Suchantworten vorkommen sind zwei getrennte Entscheidungen. Dieselbe Trennung gibt es bei Perplexity, wo PerplexityBot der Suche dient und Perplexity-User nutzerinitiierte Zugriffe abbildet.
Eine robots.txt, die pauschal alle KI-Bots aussperrt oder alle erlaubt, trifft in beiden Fällen für einen Teil der eigenen Ziele die falsche Wahl.
Wo liegt das Problem meistens tatsächlich?
In der Beratungspraxis liegt die häufigste Ursache gar nicht in der robots.txt, sondern im Content Delivery Network oder in der Firewall – und zwar durch Voreinstellungen, die niemand im Unternehmen jemals bewusst getroffen hat.
Cloudflare blockiert bei neu angelegten Domains seit Juli 2025 standardmäßig AI-Training-Crawler. Seit dem 15. September 2026 unterscheidet Cloudflare die Regeln stärker nach dem Zweck eines Crawlers: Search, Agent und Training werden getrennt behandelt. Für neue Domains, neue Websites bestehender Kunden und alle Kunden im kostenlosen Tarif, die ihre Einstellungen nicht selbst angepasst haben, werden Training und Agent auf Seiten mit Werbung standardmäßig blockiert, Search bleibt erlaubt.
Der entscheidende Punkt steckt im Detail: Multi-Purpose-Crawler, die mehrere Funktionen kombinieren, werden nach der jeweils restriktivsten aktivierten Regel behandelt. Cloudflare nennt ausdrücklich Googlebot, Applebot und BingBot als Beispiele. Wer also Training-Crawler blockiert, kann unter bestimmten Einstellungen auch klassische Suchmaschinen-Crawler mitblockieren – und damit nicht nur KI-Sichtbarkeit, sondern das Google-Ranking gefährden.
Das ist keine theoretische Konstellation. Der ursprüngliche „Block AI Bots“-Schalter aus dem Jahr 2025 wurde von vielen Shopbetreibern mit einem Klick aktiviert, ohne dass jemand die Konsequenzen für 2026 absehen konnte. Wer das nie überprüft hat, sollte es tun.
Was bringt Shopware selbst an strukturierten Daten mit?
Shopware liefert seit Langem strukturierte Produktdaten im Standard-Storefront aus. Mit Version 6.7.9.0 wurde die technische Umsetzung grundlegend modernisiert: Statt der bisherigen, über HTML-Attribute verstreuten Microdata gibt der Storefront strukturierte Daten jetzt als JSON-LD im Seitenkopf aus.
Ein Detail, das in der Praxis regelmäßig übersehen wird: Die Funktion ist zunächst optional und wird über den Feature Flag JSON_LD_DATA aktiviert. Standardmäßig ist der Flag ausgeschaltet – dann läuft weiterhin die alte Microdata-Ausgabe. Wer 6.7.9.0 installiert hat und annimmt, damit automatisch JSON-LD auszuliefern, irrt sich. Die alte Microdata gilt als veraltet und entfällt mit Version 6.8.0.0.
Inhaltlich geht das neue Product-Schema deutlich weiter als die frühere Microdata. Enthalten sind unter anderem:
alle Produktbilder statt nur des Coverbildes
AggregateRatinginklusive der erforderlichen Bewertungsanzahl sowie bis zu zehn aktuelle EinzelbewertungenOfferShippingDetailsmit Lieferzeit bei Produkten mit einfachem Preistypisierte Maße und Gewichte sowie
gtin13undmpn, sofern gepflegtneu:
WebSite-Schema mit Suchfunktion,Organization-Schema mit Shop-Logo,ItemList-Schema auf Kategorie- und Suchergebnisseiten undVideoObject-Einträge für Produktvideos
Wer auf einer älteren Version arbeitet oder eigene Storefront-Templates einsetzt, sollte nicht davon ausgehen, dass dieselben Informationen automatisch vorhanden sind.
Technikbox für Entwickler und Agentur: Jedes JSON-LD-Schema liegt in einem eigenen Twig-Template unter storefront/layout/structured-data/. Jedes Template stellt zwei Blöcke bereit: einen äußeren mit der Datenlogik und einen inneren _script-Block für die Ausgabe. Erweiterungen erfolgen über die Standard-Template-Mechanik – Daten ins jeweilige Data-Objekt mergen, dann {{ parent() }} aufrufen. Wer in der Vergangenheit eigene itemprop-Attribute ergänzt hat, muss diese vor dem Umstieg auf 6.8.0.0 migrieren, da die Microdata dann entfällt.
Wie öffnet Shopware den direkten Weg zu KI-Plattformen?
Mit Version 6.7.10.0 hat Shopware einen eigenen Sales-Channel-Typ „Agentic Commerce“ eingeführt, zunächst als experimentelle Funktion. Produkte lassen sich darüber als JSONL-Feed exportieren, ein vorkonfiguriertes Template deckt die Pflichtfelder ab, und Bestellungen sowie Traffic aus KI-Plattformen lassen sich über die bestehende Affiliate-Infrastruktur nachverfolgen.
Inzwischen gibt es zusätzlich eine eigene Erweiterung von Shopware, die deutlich weiter geht: neben Feeds für OpenAI und Google unterstützt sie das Universal Commerce Protocol.
Zwei Dinge, die oft verwechselt werden:
Produkt-Feed: sorgt dafür, dass Ihre Produkte zur KI kommen – als strukturierter Datenstrom.
Universal Commerce Protocol: geht einen Schritt weiter. KI-Agenten können mit dem Shop interagieren – Katalog abfragen, Warenkorb füllen, Checkout auslösen, Bestellungen einsehen.
Was das strategisch bedeutet, behandelt Kapitel 9.
Wie ernst sollte man das heute nehmen?
Beta heißt hier tatsächlich Beta. Shopware kennzeichnet die Erweiterung ausdrücklich als Beta-Version; Funktionsumfang und Verhalten können sich noch ändern. Gleichzeitig ist die Verbreitung derzeit noch gering.
Das ist kein Argument gegen die Richtung – die ist erkennbar richtig. Es ist ein Argument gegen einen unkritischen produktiven Einsatz. Wer die Erweiterung heute ausprobiert, sollte das zuerst auf einer Staging-Umgebung tun und insbesondere Warenkorb, Checkout, Bestellungen und die für KI-Agenten freigegebenen Funktionen sauber testen.
Dazu kommt eine geografische Einschränkung: Die Registrierung als Händler im ChatGPT-Marketplace ist laut Shopware-Dokumentation derzeit auf die USA beschränkt und in Europa noch nicht verfügbar. Für Shopware-Händler mit US-Geschäft ist der Kanal damit heute schon relevant. Für den rein europäischen Markt lässt sich der technische Unterbau vorbereiten, während die Ausspielung noch aussteht.
Warum diese Asymmetrie interessant ist: Wer im US-Geschäft aktiv ist, sammelt heute Erfahrungen, die europäische Wettbewerber erst später machen werden. Und wer nur in Europa verkauft, hat eine Vorlaufzeit, um Produktdaten und Feed-Struktur sauber aufzusetzen. Beides ist besser, als überrascht zu werden.
Zwei praktische Punkte beim Einrichten: Eigenschaften wie Farbe oder Größe sind in Shopware keine Systemfelder, sondern müssen als Properties angelegt und im Feed manuell gemappt werden. Und eine URL zu den Rückgabebedingungen ist Pflichtangabe – Shopware liefert dafür keine einheitliche Standardseite, weil die rechtlichen Anforderungen je nach Region unterschiedlich sind.
Was lehrt ein Fall aus dem Shopware-Code selbst?
Wie schnell technische Zugänglichkeit kippen kann, zeigt ein Fall aus Shopwares eigener Entwicklung. Die Links der Agentic-Commerce-Feeds tragen einen Tracking-Parameter für die Zuordnung des Sales Channels. Die Standard-robots.txt der Storefront sperrte mit einer pauschalen Regel jedoch alle URLs mit Parametern – womit Googlebot genau diese Landingpages nicht crawlen konnte. Die Folge: Google Merchant Center lehnte die betroffenen Produkte ab. Behoben wurde das erst mit Version 6.7.13.0.
Eine einzige Zeile in der robots.txt hat ein komplettes Sortiment aus einem Vertriebskanal geworfen – während der Shop für jeden menschlichen Besucher tadellos funktionierte.
Der Punkt daran ist nicht, Shopware einen Fehler vorzuhalten. Solche Wechselwirkungen entstehen überall dort, wo neue Funktionen auf gewachsene Konfigurationen treffen. Der Punkt ist: Diese Prüfung gehört auf die Checkliste – und nicht nur einmal, sondern nach jedem größeren Update.
Welche Erwartung sollte man an strukturierte Daten nicht haben?
Strukturierte Daten sind Pflicht. Sie sind kein Zaubermittel. Eine Auswertung von Ahrefs über 1.885 Seiten, die zwischen August 2025 und März 2026 JSON-LD-Schema neu eingeführt haben, fand im Vergleich zu rund 4.000 Kontrollseiten keinen nennenswerten Zitations-Vorteil durch Schema allein – weder bei Google AI Overviews und AI Mode noch bei ChatGPT. Untersucht wurden allerdings Seiten, die bereits regelmäßig zitiert wurden.
Zur Einordnung: Schema macht Inhalte maschinenlesbarer. Es macht schlechte Inhalte nicht besser. Wer schwache Produktinformationen sauber in JSON-LD verpackt, hat am Ende vor allem eines: sauber strukturierte schwache Produktinformationen. Technik schafft die Voraussetzung – sie ersetzt nicht die inhaltliche Antwort auf die Frage, die ein Kunde tatsächlich hat.
Was Sie heute in zehn Minuten prüfen können
Rufen Sie Ihre wichtigste Produktseite mit dem User-Agent von OAI-SearchBot ab. Kommt eine normale Seite mit Inhalt zurück – oder eine Fehlermeldung, eine leere Seite, eine Weiterleitung?
Prüfen Sie Ihre robots.txt auf explizite Einträge für OAI-SearchBot, PerplexityBot und vergleichbare Suchagenten – nicht nur auf die bekannteren Trainings-Crawler.
Werfen Sie einen Blick in den Quelltext: Steht der Preis direkt im HTML, oder erscheint er erst nach dem Laden im Browser?
Wenn Sie Cloudflare oder ein vergleichbares CDN einsetzen: Prüfen Sie die Bot-Management-Einstellungen. Was dort vor einem Jahr mit einem Klick aktiviert wurde, kann heute eine andere Wirkung haben als damals gedacht.
Wenn Sie auf Shopware 6.7.9.0 oder neuer laufen: Prüfen Sie, ob der Feature Flag für JSON-LD tatsächlich aktiviert ist.
Häufige Fragen
Die eigenständigen Crawler von OpenAI, Anthropic und Perplexity tun das nach Analysen von Vercel und MERJ nicht. Google rendert dagegen über die Googlebot-Infrastruktur. Inhalte, die erst per Skript entstehen, fehlen für ChatGPT, Claude und Perplexity deshalb häufig.
Das ist eine eigene Entscheidung, getrennt von der Sichtbarkeit in der ChatGPT-Suche. GPTBot sammelt Trainingsdaten, OAI-SearchBot macht Inhalte für die Suche zugänglich. Wer GPTBot sperrt, kann OAI-SearchBot trotzdem gezielt zulassen.
Ab Version 6.7.9.0 ja, aber erst nach Aktivierung des Feature Flags JSON_LD_DATA. Standardmäßig läuft weiter die alte Microdata-Ausgabe, die mit Version 6.8.0.0 entfällt.